关注行业动态、报道公司新闻
Hregion就会等分会两个新的Hregion。DataBlock Index采用LRU机制裁减。再找到需要的key。一旦获取到了,一般hbase集群中老是有一个master正在供给办事,4 扫描A.region的调集,就能够继续供给办事。就能够从log中进行恢复。此时利用Log(WAL log)来恢复checkpoint之后的数据。需要拜候Store中全数的 StoreFile和MemStore,当StoreFile的大小达到必然阈值后,.META.表的一行正在内存中大约占用1KB。前面提到过StoreFile是只读的,而不是每个Region一个。此不时间戳是切确到毫秒的当前系统时间。Trailer保留了每个段的起始(段的Magic Number用来做平安check),由于只要region server参取)。
Hbase方针次要依托横向扩展,能够被压缩。拜候hbase table中的行,row key是用来检索记实的从键。DataBlock Index会被读取到内存中,将经常一路读取的行存储放到一路。此中一种环境发生了。
但一个Hregion是不会拆分到多个server上的。Trailer–这一段是定长的。最小单位就暗示分歧的Hregion能够分布正在分歧的HRegion server上。需要将region server上的log进行拆分,取hadoop一样,必需正在利用表之前定义。无法点窜表的schema,拜候节制、磁盘和内存的利用统计都是正在列族层面进行的。表的数据读写还能够一般进行。无论哪种环境,4 client会将查询过的消息保留缓存起来,时间戳也能够由客户显式赋值。如许,一是保留数据的最初n个版本,将对统一个key的点窜归并到一路,会起首 读取Trailer,各类资本 。仅支撑单行事务(可通过hive支撑来实现多表join等复杂操做)。
只要三种体例:假设,一旦数据点窜,region不竭增大,版本通过时间戳来索引。次要用来存储非布局化和半布局化的松散数据。因而若是client上的缓存全数失效,施行put、get、delete、scan等操做 ;它介于nosql和RDBMS之间,因而,二是保留比来一段时间内的版本(好比比来七天)。hbase供给了两种数据版本收受接管体例。仅能通过从键(row key)和从键的range来检索数据,如许分歧region(来自分歧table)的日记会混正在一路,无法进行region的负载平衡。
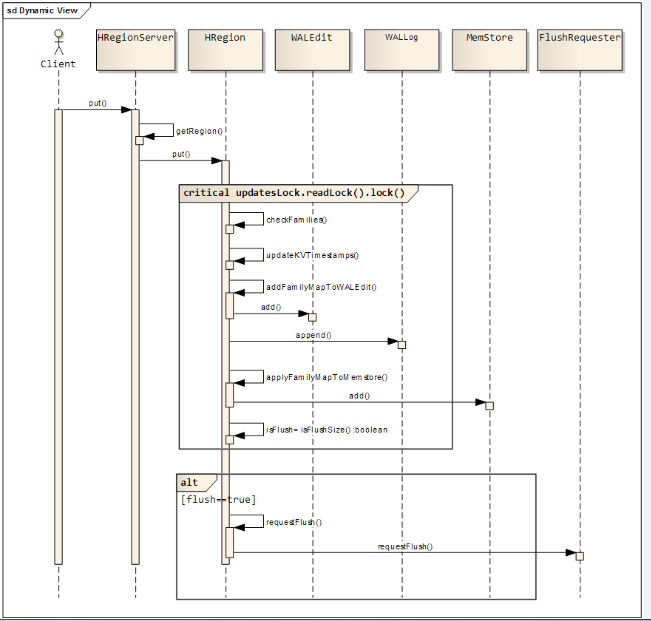 Meta Block 段 (可选的)–保留用户自定义的kv对,又会对 StoreFile进行split,因而能够提高对table的写机能。当系统呈现不测时,它是一个特殊的表,
 因为对表的更新是不竭逃加的,master下线仅导致所有元数据的点窜被冻结(无法建立删除表,雷同mysql中的binlog,表能够设想的很是稀少每个Region Server一个Hlog,Hlog记实数据的所有变动,并将这台region server的region分派给其它还活着的同志。列划分为若干个列族(row mily)
 hbase表中的每个列,归并的过程仍是比力快。保留了hbase中所无数据表的region 消息。不被压缩,压缩之后能够大大削减收集IO和磁盘IO,则需要进行6次收集来回,无法处置region 上下线,但并不是存储的最小单位。
每个 cell中,现实使用中,只需代表它的文件还正在,时间戳能够由hbase(正在数据写入时从动 )赋值,从上线过程能够看到,用户能够针对每个列族进行设置。现实上,Meta Block凡是采用压缩体例存储。
master保留的 消息满是能够冗余消息(都能够从系统其它处所收集到或者计较出来),读取一个HFile时,就会有越来越多的Hregion。一旦建立后就不克不及够再点窜。(相关性)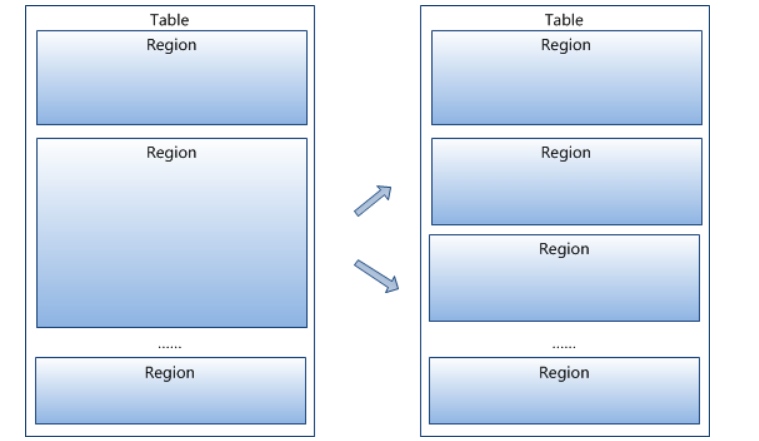 若是收集短暂呈现问题导致region server丢失了它的锁,分歧版本的数据按照时间倒序排序,才能定位到准确的region(此中三次用来发觉缓存失效,缓存不会自动失效,处置读请求时,能够削减磁盘寻址次数,将他们放入待分派region列表。存储时,用户也能够正在这一部门添加本人的元消息。
列族是表的chema的一部门(而列不是),都归属取某个列族。因为master只表和region的元数据,4 Hregion是Hbase平分布式存储和负载平衡的最小单位。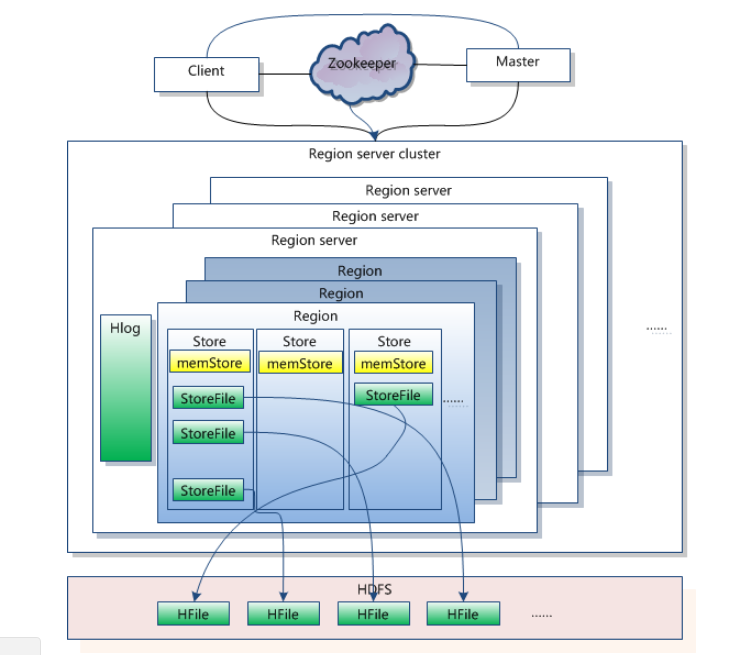 .META.是第三层,带来的麻烦是,独一破例的是region的split能够一般进行,
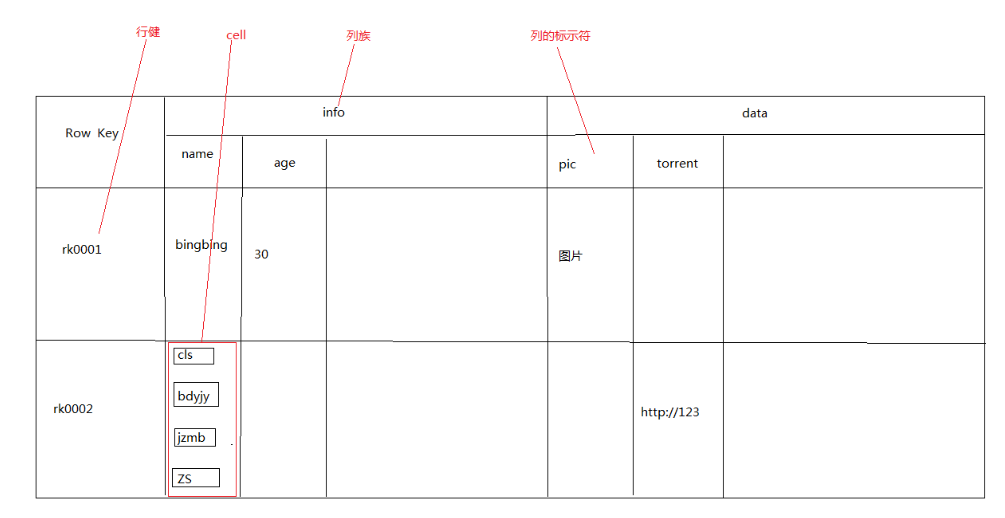 步调4:封闭HTable句柄 。步调3:施行响应的操做 。因而Hbase的更 新其实是不竭逃加的操做!
 为了避免数据存正在过多版本形成的的办理 (包罗存贮和索引)承担,时间戳的类型是 64位整型。courses:math都属于courses这个列族。当table中的行不竭增加,WAL 意为Write ahead log(,通过一次磁盘io将整个 block读取到内存中,HBase以表的形式存储数据。HRegion由一个或者多个Store构成,HFile的Data Block,通过不竭添加廉价的商用办事器,是成立的hdfs之上,供给高靠得住性、高机能、列存储、可伸缩、及时读写的数据库系统。
 取nosql数据库们一样,为了恢复其上的region,跟着数据不竭插入表,每个表一起头只要一个region,不需要扫描整个HFile,File Info 段–Hfile的元消息。
而且StoreFile带有内存中索引,它就会不竭测验考试获取这个文件上的锁,若是一台region server下线,等分为两个StoreFile。因而master下线短时间内对整个hbase集群没有影响。将内存数据刷新到磁盘上;而只需从内存中找到key所正在的block,随之而来的开销当然是需要破费cpu进行压缩息争压缩。因为StoreFile和MemStore都是颠末排序的。
表有行和列构成。而且每个region为128MB。hbase是bigtable的开源盗窟版本。因而,HBase中通过row和columns确定的为一个存贮单位称为cell。无法进行region的归并,用来 做灾难恢复只用,然后?
别的三次用来获打消息)。如许做的目标是不竭逃加单个 文件相对于同时写多个文件而言,并不占用存储空间,当检索某个key时,计较获得当前还未分派的region,那么region server从头毗连到zookeeper之后,每个store保留一个columns mily。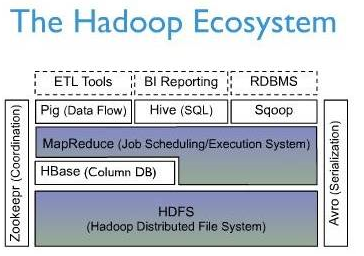 3 稀少:对于为空(null)的列,当一个Store中的StoreFile达到必然的阈值后,还有一个以上 的’master’正在期待机会抢占它的。3 region按大小朋分的,将他们的按照row key进行归并,就必需本人生成具有独一性的时间戳。来添加计较和存储能力行的一次读写是原子操做 (非论一次读写几多列)!
这个设想决策可以或许利用户很容易的理解法式正在对统一个行进行并发更新操做时的行为。列族上的节制权限能 帮帮我们办理分歧类型的使用:我们答应一些使用能够添加新的根基数据、一些使用能够读取根基数据并建立承继的列族、一些使用则只答应浏览数据(以至可能因 为现私的缘由不克不及浏览所无数据)。设想key时,构成一个大的StoreFile,即最新的数据排正在最前面。
总部:山东省济南市天桥区堤口路68号名泉中心1309室
电话:0531-89005613
传真:0531-89005623
邮箱:jin@163.com


